CUDA 编程入门:从执行模型到可靠的 kernel
以 RTX 5090 Laptop GPU 为实验环境,用 nvcc 命令行编译运行 CUDA,理解线程分工与数据传输,校验结果并比较 CPU、GPU kernel 和完整路径的时间。
学完这一讲,你能
- 区分 GPU 型号、计算能力与 CUDA 工具链版本
- 用 nvcc 命令行编译运行程序,追踪线程索引、传输与错误检查
- 在 RTX 5090 Laptop 实验环境比较 CPU、GPU kernel 与含传输路径
本讲路线
从一段 CPU 循环,到一个能验证的 CUDA 程序
前四讲已经讨论了并行执行、存储和同步。这一讲把它们落实到可以编译运行的代码。
我们以配备 RTX 5090 Laptop GPU 的机器作为实验环境,完成一次向量加法。
- 看懂 GPU 型号、CUDA 版本和设备属性。
- 用 nvcc 编译运行 Hello,观察线程的编号。
- 写出数组上传、线程计算、结果下载与校验。
- 比较 CPU 时间、GPU kernel 时间和包含传输的完整时间。
课堂沿着同一个例子逐步增加代码;每一步都能运行并观察输出。
认识实验环境
实验环境:RTX 5090 Laptop GPU + CUDA 12.8
本讲使用以下配置进行演示和评测;设备与工具链已完成编译、运行和结果校验。
| 项目 | 实验配置(2026-10-22 核验) |
|---|---|
| GPU | NVIDIA GeForce RTX 5090 Laptop GPU |
| 架构 / CC / SM 数 | Blackwell / 12.0 / 82 |
| 可见显存 / L2 | 23.889 GiB / 64 MiB |
| 系统 / 驱动模式 | Windows 11 / WDDM |
| NVIDIA 驱动 | 591.91 |
| Toolkit / Host 编译器 | CUDA 12.8.61 / MSVC 19.29 |
| CPU | Intel Core Ultra 9 275HX |
这里的 Laptop 后缀不能省略,桌面 RTX 5090 的规格不适用于这台实验设备。后面的时间表均来自上述配置。
MiB、GiB 分别以 、 字节计。
先在终端运行一次 nvidia-smi
实验环境在 2026-10-23 00:21:34 的实际输出节选(保留 GPU 状态表):
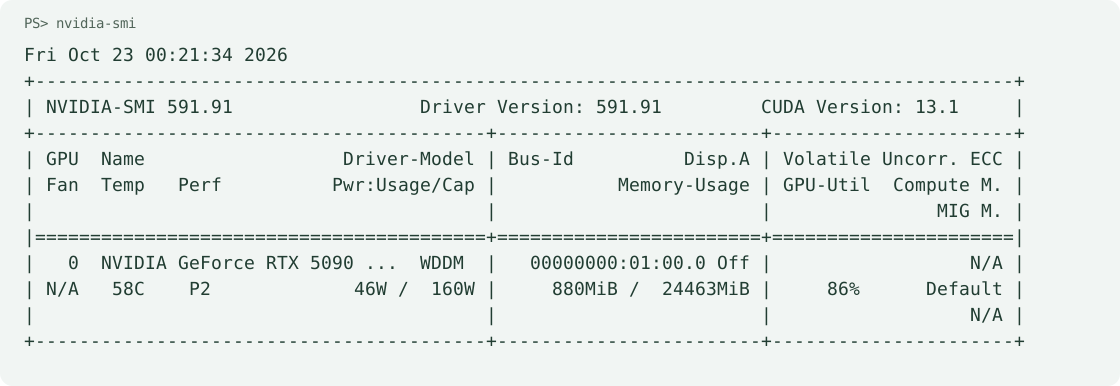
型号列被截断时,用 nvidia-smi --query-gpu=name --format=csv 查看全名。温度、功耗和利用率是采样时的状态,每次运行会变化。
这张状态快照与后面的性能评测不是同一次采样。
这些字段,比一个 GPU 名字更有意思
| 快照中的字段 | 可以读出什么 |
|---|---|
880 MiB / 24463 MiB | 当前显存占用 / 可见总容量;不是显存带宽 |
GPU-Util = 86% | 采样窗口内约 86% 的时间有 kernel 在执行;下一页对比不同负载 |
Perf = P2 | 性能状态:P0 最高、P12 最低;会随负载和管理策略变化 |
46 W / 160 W、58 C | 当时的功耗 / 报告的功耗上限,以及温度;可帮助观察持续运行的变化 |
Compute M. = Default | 允许多个进程使用设备的计算模式;与 block 默认大小无关 |
N/A 表示当前设备或模式不能提供这个字段;不能把风扇、ECC 等项的 N/A 读成 0。WDDM 是 Windows 的显示驱动模式;进程表也不是系统全部 GPU 活动的完整记录。
现场观察:nvidia-smi -l 1 每秒刷新一次,按 Ctrl+C 停止。字段定义。
GPU-Util 相同,GPU 可能在做很不同的事
GPU-Util 统计执行 kernel 的时间占比,不统计算力用了几成。
假设 1 秒中有 0.86 秒至少一个 kernel 在执行,就对应约 86%。
| 理想化负载 | GPU-Util 与实际工作情况 |
|---|---|
| 少量线程持续运行 | 接近 100%,很多计算资源仍空闲 |
| 大量读写、少量运算 | 接近 100%,可能受访存限制 |
| 充分并行、复用良好的矩阵乘 | 接近 100%,可能接近相应计算峰值 |
| 每轮算 2 ms,空闲 8 ms 等 CPU | 约 20%,但那 2 ms 内也可能很高效 |
高利用率不等于高吞吐。 本讲仍用结果校验和运行时间做比较。
数值为教学示意;采样窗口由设备决定,-l 1 只指定每秒刷新。指标定义。
训练中的三种等待
GPU 算完上一批,下一步却还不能开始,常见有三种原因:
| 等待原因 | 训练中的例子 | 下一步需要什么 |
|---|---|---|
| CPU 还没准备好数据 | DataLoader 读文件、解码、数据增强 | 下一批输入准备好 |
| 数据还没传到显存 | x = x.to("cuda") | 输入传输完成 |
| CPU 还没提交后续计算 | Python 循环、许多小算子的调用开销 | 后续 kernel 提交过来 |
默认 .to("cuda") 也会让 CPU 等传输完成;依赖输入的 GPU 计算则要等数据就绪。传输忙,不代表有计算 kernel 在执行。
假设每轮 GPU 算2 ms,再空等 CPU 准备数据8 ms;两段不重叠、也无其他计算,则 GPU-Util 约为 2/(2+8)=20%。
A100、H200、B300 的名字怎么读
| 产品与架构 | 名称背后的人物 | 代表成就 |
|---|---|---|
| A100 · Ampere | 安培(André-Marie Ampère) | 研究电流间的作用力,奠定电动力学基础;电流单位“安培”以他命名 |
| H100/H200 · Hopper | 格蕾丝·霍珀(Grace Hopper) | 开发早期编译系统 A-0,推动 COBOL,让高级语言编程更普及 |
| B200/B300 · Blackwell | 大卫·布莱克韦尔(David Blackwell) | Rao–Blackwell 定理改进统计估计;1965年成为首位当选美国国家科学院的黑人学者 |
“bug”的故事与霍珀有关,但这个词不是她发明的。 1947年,Mark II 团队发现并把一只蛾子贴进日志;工程师在19世纪就已用 bug 指故障。霍珀与团队帮助传播了 computer bug、debug 的用法。馆藏说明。
字母对应架构家族,数字区分产品型号;B300 属于 Blackwell Ultra。下一页看相邻型号为什么升级。
从 100、200 到 300,究竟升级了什么
看升级动机,要把新增硬件与应用瓶颈对应起来。 这里选取与大模型相关的几项:
| 产品变化 | 加强了什么 | 针对什么需求 |
|---|---|---|
| A100 → H100 | Hopper:FP8、Transformer Engine | Transformer矩阵运算重;在精度可接受时降低计算与搬运成本 |
| H100 → H200 | 同为Hopper;显存80→141 GB,带宽3.35→4.8 TB/s | 权重与历史上下文缓存占空间、读取耗时;需要装得下、读得快 |
| H200 → B200 | Blackwell:FP4、更快的GPU间互连 | 更大模型的推理成本高、跨卡交换多;加强低精度计算与通信 |
| B200 → B300 | Blackwell Ultra:更大显存,更强FP4与注意力计算 | 长上下文、长生成、高并发;缓存需求和注意力开销继续增长 |
H100/H200 按 SXM 版本比较;B200/B300 显存带宽上限仍是 8 TB/s。容量解决存多少,带宽解决读多快,计算单元解决算多快,三者不会必然同比例提高。
计算能力 7.5,不是 7.5 TFLOPS
Compute Capability(CC,计算能力) 用“主版本.次版本”表示硬件支持的指令和功能。7.5 中 7 是主版本、5 是次版本;没有 FLOP/s 单位。
| 示例设备 | CC | 面向该架构的常见编译目标 |
|---|---|---|
| T4 / RTX 2070 | 7.5 | sm_75 |
| A100 | 8.0 | sm_80 |
| H100 / H200 | 9.0 | sm_90 |
| B200 / B300 | 10.0 / 10.3 | sm_100 / sm_103 |
| 实验设备 RTX 5090 Laptop GPU | 12.0(实测) | sm_120 |
CC 是功能版本号,不是算力分数。 同一 CC 的显卡也会因执行单元数量、频率不同而有不同算力;比较 FLOP/s 要指定精度与指令。
CC 12.0 不表示比 CC 10.3 的 B300 更快。 新 CC 可能支持高吞吐指令,但编号不能换算成加速比。
来源:NVIDIA CC 对照表。编译目标还须得到 Toolkit 支持,下一页说明。
CUDA 环境中的几种版本
| 从哪里看到 | 实验环境中的值 | 回答的问题 |
|---|---|---|
nvidia-smi 的 CUDA Version | 13.1 | 驱动最高支持到哪个 CUDA 版本 |
nvcc --version | 12.8.61 | 实际使用哪个 Toolkit 编译 |
| 设备的 Compute Capability | 12.0 | GPU 支持哪些架构功能 |
CC 与 CUDA 版本不能比较大小;同一 CC 可以使用多个版本的 Toolkit。 驱动显示 CUDA 13.1,不等于已安装 Toolkit 13.1。
例如 CC 7.5 的 T4 可用 CUDA 12.8,目标仍是 sm_75;实验显卡 CC 12.0 使用同一个 Toolkit,目标是 sm_120。
选择 Toolkit 要同时检查:它是否支持该 GPU 架构、驱动是否兼容。 新版可能移除老架构支持;用 nvcc --list-gpu-code 查看当前编译器支持的目标。
PyTorch 与 CUDA 开发环境
CUDA 版预编译 PyTorch 通常会携带或依赖安装运行库;完整 CUDA Toolkit 还提供 nvcc、头文件等开发工具。
| 要做的事 | 需要的环境 |
|---|---|
| 运行现成 PyTorch GPU 算子 | PyTorch 及运行库,通常无需另装 Toolkit |
编译本讲的 .cu | Toolkit + C++ 编译器,无需 PyTorch |
| 编译 PyTorch CUDA 扩展 | PyTorch + Toolkit + C++ 编译器 |
第三种情况两者都要:Toolkit 负责把 .cu 编译出来,PyTorch 负责加载调用。 所有情况都需要兼容的 NVIDIA 驱动,安装 PyTorch 不会替你安装驱动。
查版本:torch.version.cuda 看 PyTorch 的构建版本,nvcc --version 看 Toolkit;编译扩展时优先匹配两者的 CUDA 版本。
来源:PyTorch 维护者说明 · CUDA 扩展工具链要求。
安装与验证编译环境
Windows 上先备齐驱动、C++ 编译器与 Toolkit
本讲采用 先安装驱动 → 安装 C++ 工具链 → 安装 CUDA Toolkit → 编译运行验收 的顺序。
| 组件 | 在程序运行中负责什么 | 本讲实验配置 |
|---|---|---|
| NVIDIA 驱动 | 操作系统与 GPU 之间的支持 | 591.91,nvidia-smi 能识别设备 |
| MSVC + Windows SDK | 编译、链接 .cu 中的 CPU 代码 | VS 2019 Build Tools,MSVC 19.29 |
| CUDA Toolkit | nvcc、CUDA 头文件、开发库与工具 | 12.8.61,支持 sm_120 |
VS Code 是编辑器,C/C++ 扩展也不自带 MSVC 编译器。 可以只安装 Visual Studio Build Tools,无需使用完整 Visual Studio IDE 写课上代码。
选择版本先看 CUDA 12.8 的 Windows 编译器支持表。复现本讲采用上表组合;不能仅因为都是“最新版”就认为兼容。
C++ 工具链:找到这一个工作负载
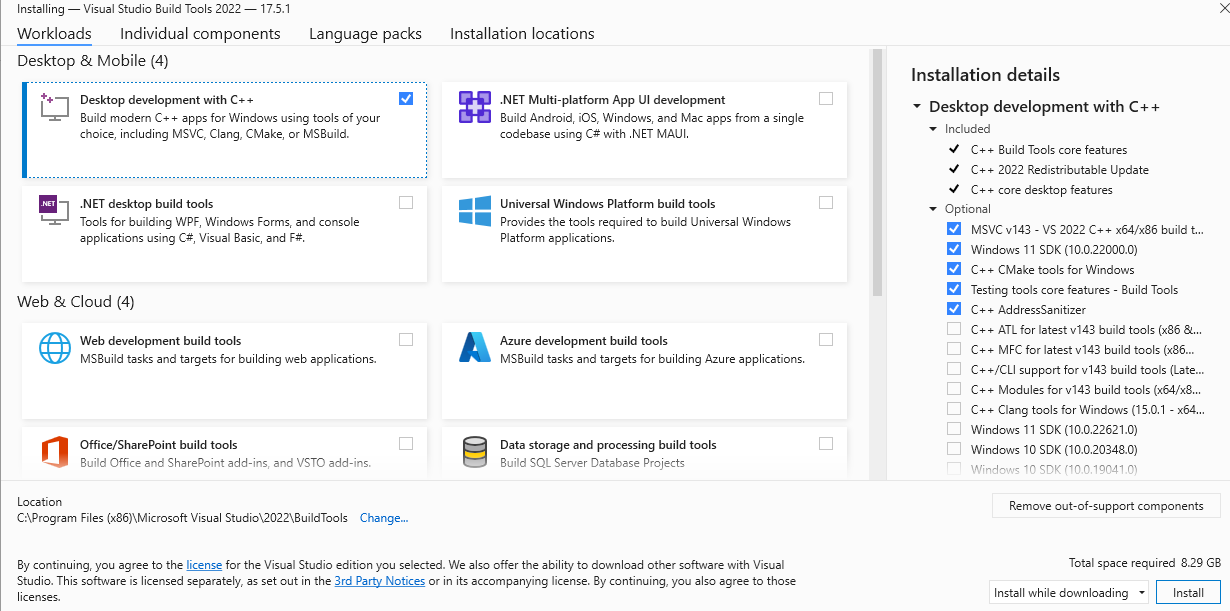
在 Visual Studio Installer 中勾选 Desktop development with C++(使用 C++ 的桌面开发),确认右侧包含 MSVC x64/x86 编译工具与 Windows SDK,然后安装。
图为微软官方 2022 界面示例。复现实验的 VS 2019 对应 MSVC v142(19.29);从微软旧版本入口选择相应 Build Tools。已有安装可在 Installer 的“修改”中补齐组件。
CUDA Toolkit:选择系统、架构和安装包
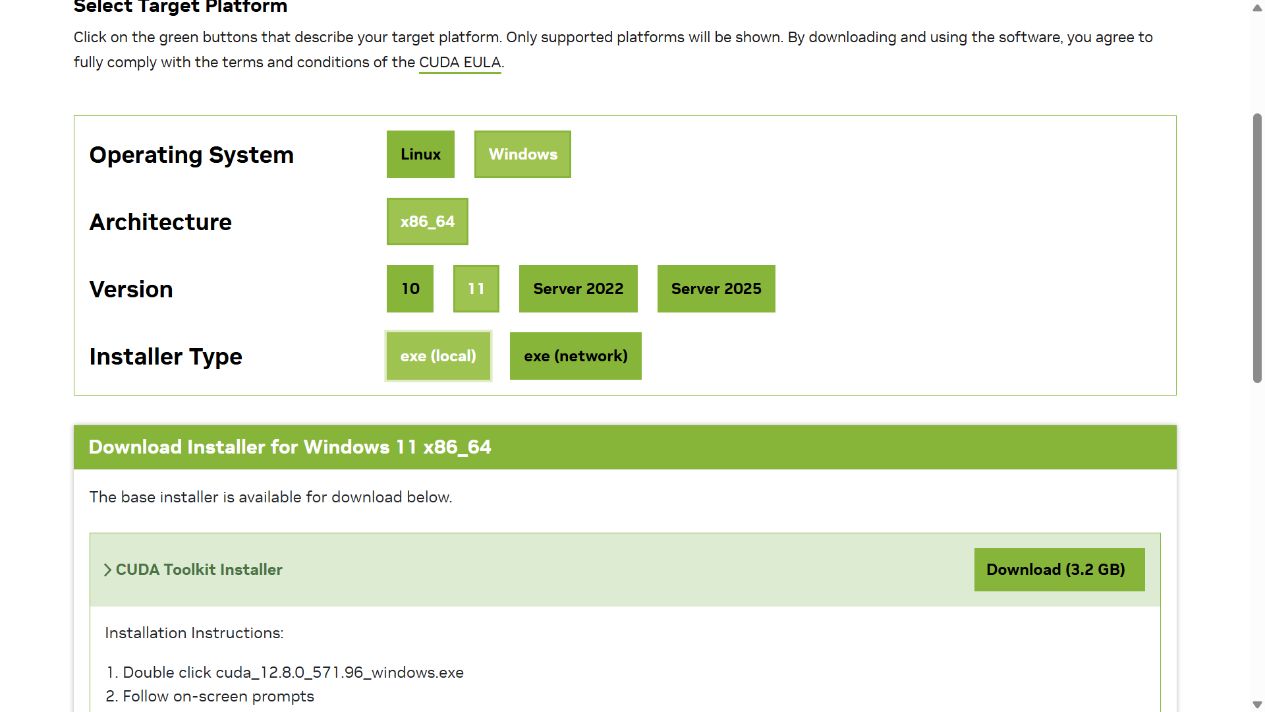
进入 CUDA 12.8 下载页,依次选 Windows → x86_64 → 11 → exe (local)。local 包含安装组件;network 在安装时再下载组件。
运行安装包,按提示安装 CUDA Toolkit 开发组件;可用默认路径 C:\Program Files\NVIDIA GPU Computing Toolkit\CUDA\v12.8。已有兼容驱动时,通过自定义安装保留现有驱动。
安装完成后重新打开开发终端。下一页用 where.exe 检查工具路径,再真正编译、运行 Hello。
编译并读懂 Hello
Hello:先看完整程序
05_hello.cu 的执行代码如下;先看全貌,下一页下载、编译,再拆解语法。
#include "common.cuh"
__global__ void hello() {
    printf("block=%u thread=%u blockDim=%u gridDim=%u global=%u\n",
           blockIdx.x, threadIdx.x, blockDim.x, gridDim.x,
           blockIdx.x * blockDim.x + threadIdx.x);
}
int main() {
    device_info();
    hello<<<2, 4>>>();
    CUDA_CHECK(cudaGetLastError());
    CUDA_CHECK(cudaDeviceSynchronize());
    std::puts("PASS: hello completed; the order of printed threads is not guaranteed.");
}
先沿 main 读:打印设备 → 启动 GPU 打印 → 检查并等待 → 报告完成。common.cuh 提供设备信息和错误检查辅助函数,后面解释。
用 nvcc 编译并运行第一个程序
下载第五讲全部源码(ZIP):四个 .cu 及 common.cuh。打开 x64 Native Tools Command Prompt for VS 2019(CMD),进入解压位置,执行:
cd ".\课堂演示\05-cuda-introduction"
dir /b *.cu *.cuh
code .
where.exe nvcc
where.exe cl
nvcc -std=c++17 -arch=sm_120 05_hello.cu -o hello.exe
.\hello.exe
| 命令中的部分 | 作用 |
|---|---|
cd、dir、code . | 进入目录、查看文件、用 VS Code 打开该讲 |
-std=c++17、-arch=sm_120 | C++17 标准;实验 GPU 的 CC 12.0 编译目标 |
-o hello.exe、.\hello.exe | 生成指定文件;运行当前目录中的程序 |
where.exe 检查工具路径。编译成功再运行,应有 8 条线程信息和 PASS。后续沿用此目录;换卡时调整 -arch。
区分 CPU 函数与 GPU 核函数
同一个 .cu 文件可以包含两种执行位置。 main() 在 CPU 上运行;带 __global__ 的函数是 GPU kernel(核函数)。
| 写法 | 本讲中的调用与执行方式 |
|---|---|
普通函数,或 __host__ 函数 | CPU 调用,在 CPU 上执行;普通函数默认如此 |
__global__ void hello() | CPU 用 <<<...>>> 启动,在 GPU 上执行,返回类型为 void |
__device__ 函数 | GPU 代码调用的辅助函数,在 GPU 上执行 |
__global__ void hello() { printf("Hello from GPU!\n"); }
// 在 CPU 的 main() 中提交 GPU 工作:
hello<<<2, 4>>>();
上面是简化片段:先看执行位置,下一页拆解 <<<2, 4>>>。__global__ 函数体会由本次启动的每个线程分别执行。
读懂 hello<<<2, 4>>>()
hello<<<2, 4>>>(); // 2 个 block,每块 4 个线程,无函数参数
一次启动的全部 block 组成一个 grid;每个 block 包含若干 thread。
| 部分 | 在这个一维例子中的含义 |
|---|---|
hello | 要执行的 kernel 名称 |
<<<2, 4>>> | 启动 2 个 block,每个 block 有 4 个线程 |
() | 传给 hello 的参数;它没有形参,所以为空 |
因此一共 2 × 4 = 8 个线程,各执行一次函数体。若函数只打印一次,就会产生 8 条线程输出;这不保证 8 个线程同时执行或按顺序执行。
后面会写 add<<<blocks, threads>>>(d_a, d_b, d_c, n):尖括号决定线程组织,圆括号传递数组地址和长度。
每个线程怎样知道自己负责哪里
CUDA 在 GPU 代码中提供以下只读内建变量,无需自行声明。名称区分大小写,写作 blockIdx、threadIdx,其中 Idx 表示 index(索引)。
| 一维写法 | 含义 | hello<<<2, 4>>>() 中的值 |
|---|---|---|
blockIdx.x | 当前 block 在 grid 中的编号 | 0 或 1 |
threadIdx.x | 当前线程在所在 block 中的编号 | 每个 block 内都是 0…3 |
blockDim.x | 每个 block 的线程数 | 4 |
gridDim.x | grid 中的 block 数 | 2 |
.x 取 x 方向分量;Dim 表示规模。编号从 0 开始,全局一维编号由我们计算:i = blockIdx.x * blockDim.x + threadIdx.x。
block 0:thread 0 1 2 3 → i = 0 1 2 3
block 1:thread 0 1 2 3 → i = 4 5 6 7
把线程坐标打印出来,核对这 8 次执行
__global__ void hello() {
    printf("block=%u thread=%u blockDim=%u gridDim=%u global=%u\n",
           blockIdx.x, threadIdx.x, blockDim.x, gridDim.x,
           blockIdx.x * blockDim.x + threadIdx.x);
}
// main 中的核心步骤;完整源码还检查错误
hello<<<2, 4>>>();
cudaDeviceSynchronize();
例如 block=1 thread=2 blockDim=4 gridDim=2 global=6:第 1 号 block 的第 2 号线程,对应全局编号 6。
%u 打印无符号整数,\n 换行。CPU 调用 cudaDeviceSynchronize() 等待设备完成,设备端 printf 的缓冲输出在此可见。
不保证顺序,不等于每次都会乱序。 这个程序很小,启动配置和环境相近时,多次运行可能都按 0…7 打印;这仍不是 CUDA 的顺序承诺。
应核对 global 是否完整覆盖 0…7。同步保证等待完成,不负责排序;printf 本身也会影响时序,不能从打印顺序推断线程的实际执行顺序。
只改 Hello 的启动配置,再编译一次
在同一个开发终端执行 code .\05_hello.cu,用 VS Code 编辑源码。把 hello<<<2, 4>>>() 改为 hello<<<2, 8>>>(),保存后回到终端重新执行:
nvcc -std=c++17 -arch=sm_120 05_hello.cu -o hello.exe
.\hello.exe
| 观察项 | 修改前 <<<2, 4>>> | 修改后 <<<2, 8>>> |
|---|---|---|
gridDim.x / blockDim.x | 2 / 4 | 2 / 8 |
每块的 threadIdx.x | 0…3 | 0…7 |
线程输出条数 / global 范围 | 8 条 / 0…7 | 16 条 / 0…15 |
修改源码 → 保存 → 重新编译 → 运行。.cu 是源码,.exe 是上一次编译的产物;编译成功后再运行新程序。演示后恢复 <<<2, 4>>>。
先完整读懂并修改 Hello,再把“打印编号”换成“计算数组元素”。
common.cuh 是什么,为什么 Hello 要包含它
05_hello.cu 第一行是 #include "common.cuh":把课程共用头文件的内容引入当前源码。可执行 code .\common.cuh 打开它。
| 文件或写法 | 来源与用途 |
|---|---|
#include <cuda_runtime.h> | CUDA Toolkit 的 Runtime API 头文件,声明分配、复制、同步等接口 |
#include "common.cuh" | 课程自编的辅助头文件;内部也包含 cuda_runtime.h |
05_vector_add_demo.cu | 为便于初学,直接包含所需头文件与错误检查,可单独编译 |
.cuh 是 CUDA 头文件的常用命名;common.cuh 不是 CUDA 关键字,也不是系统自带库。双引号用于寻找项目头文件;这里把它与 .cu 放在同一目录。
Hello 用到其中的 device_info()(打印设备信息)与 CUDA_CHECK(...)(检查调用是否成功)。#pragma once 防止同一编译单元内重复包含。
仍然只编译 05_hello.cu,无需把 common.cuh 单独编成程序。改了头文件,也要重新编译使用它的 .cu。
实现并验证向量加法
先把向量加法的契约写清楚
// CPU 参考定义;a、b、c 是长度为 n 的独立数组
for (size_t i = 0; i < n; ++i)
    c[i] = a[i] + b[i];
本例输入是有限 FP32 数;每个输出只依赖同位置的两个输入。输出与输入使用独立分配,n=0 返回空结果。
没有跨元素依赖,所以可以让不同线程拥有不同的输出位置。 后续增加共享数据之前,先保留这个简单的正确性理由。
向量加法核心代码(1/2):计算规则与输入
05_vector_add_demo.cu 的核心连续展示两页;取 n=1003,暂略头文件、宏定义和额外诊断。
__global__ void add(const float* a, const float* b, float* c, size_t n) {
    size_t i = size_t(blockIdx.x) * blockDim.x + threadIdx.x;
    if (i < n) c[i] = a[i] + b[i];
}
int main() {
    constexpr size_t n = 1003;
    constexpr unsigned threads = 256;
    std::vector<float> a(n), b(n);
    std::vector<float> c(n, std::numeric_limits<float>::quiet_NaN());
    for (size_t i = 0; i < n; ++i) {
        a[i] = float(int(i % 17) - 8);
        b[i] = float(int(i % 11) - 5) * 0.25f;
    }
    const size_t bytes = n * sizeof(float);
    float *d_a = nullptr, *d_b = nullptr, *d_c = nullptr;
    // main 继续见下一页
add 定义线程计算;main 准备输入并安排 GPU 工作。源码见统一下载包。
向量加法核心代码(2/2):上传、计算与校验
接上一页 main:分配 → 上传 → 计算 → 下载 → 校验 → 释放。
    CUDA_CHECK(cudaMalloc((void**)&d_a, bytes));
    CUDA_CHECK(cudaMalloc((void**)&d_b, bytes));
    CUDA_CHECK(cudaMalloc((void**)&d_c, bytes));
    CUDA_CHECK(cudaMemcpy(d_a, a.data(), bytes, cudaMemcpyHostToDevice));
    CUDA_CHECK(cudaMemcpy(d_b, b.data(), bytes, cudaMemcpyHostToDevice));
    CUDA_CHECK(cudaMemcpy(d_c, c.data(), bytes, cudaMemcpyHostToDevice));
    const unsigned blocks = unsigned(n / threads + (n % threads != 0));
    add<<<blocks, threads>>>(d_a, d_b, d_c, n);
    CUDA_CHECK(cudaGetLastError());
    CUDA_CHECK(cudaDeviceSynchronize());
    CUDA_CHECK(cudaMemcpy(c.data(), d_c, bytes, cudaMemcpyDeviceToHost));
    size_t mismatches = 0;
    for (size_t i = 0; i < n; ++i)
        if (!std::isfinite(c[i]) || c[i] != a[i] + b[i]) ++mismatches;
    CUDA_CHECK(cudaFree(d_a)); CUDA_CHECK(cudaFree(d_b)); CUDA_CHECK(cudaFree(d_c));
    std::puts(mismatches == 0 ? "PASS: every element matches." : "FAIL");
    return mismatches == 0 ? EXIT_SUCCESS : EXIT_FAILURE;
}
Host 与 Device:传指针不等于传数据
cudaMalloc 把设备分配的地址写入一个 Host 端指针变量。Host 持有这个地址值,以便把它作为参数传给 kernel;这不意味着 CPU 可以直接解引用它。
本例中 a、b、c 是 CPU 数组,d_a、d_b、d_c 保存 GPU 数组地址。d_ 是我们选的命名前缀,编译器不会靠名字决定内存位置。
向量加法 kernel:每个线程写一项
__global__ void add(const float* a, const float* b,
                    float* c, size_t n) {
    size_t i = size_t(blockIdx.x) * blockDim.x + threadIdx.x;
    if (i < n) c[i] = a[i] + b[i];
}
每个线程执行同一份函数体,用自己的坐标计算 i。if (i < n) 保护真正的数组读写。
const float* a、const float* b 表示通过这些指针只读输入;float* c 指向可写输出,n 是元素个数。Host 传入 d_a, d_b, d_c, n,kernel 用形参 a, b, c, n 接收。
size_t 是表示大小和下标的无符号整数类型;size_t(blockIdx.x) 先转换再乘,避免乘法先在较窄类型中溢出。
Q01 · 讨论
多个线程同时向数组 c 写入,为什么这里不会互相覆盖?
Q01
每个线程得到不同的 i,只写 c[i];a 和 b 只读,且与 c 独立分配。没有线程读取另一个线程刚写的 c,所以这一步不需要线程之间交换结果。
Launch 配置:指定的是一个逻辑网格
// 实际示例采用 256 threads/block;先处理 n==0
unsigned threads = 256;
unsigned blocks = unsigned(n / threads + (n % threads != 0));
add<<<blocks, threads>>>(d_a, d_b, d_c, n);
n / threads 是整数除法,n % threads 是余数;有余数时 (n % threads != 0) 为 1,补一个 block。这就是向上取整。
这个简单启动式还要求 blocks 不超过设备 grid 上限;后面的 grid-stride 版本会把启动规模与数组长度分开。
真正追踪一次边界:N=1003 时谁该停下
threads=256,blocks=,总共创建 1024 个逻辑线程。
| block | 全局索引范围 | 有效输出 |
|---|---|---|
| 0 | 0…255 | 256 项 |
| 1 | 256…511 | 256 项 |
| 2 | 512…767 | 256 项 |
| 3 | 768…1023 | 235 项 |
最后 21 个线程因 i<n 不成立而不读写。仅测试 N=1024,不能检验这种非整块长度的尾部处理。
Q02 · 讨论
若 blocks 用 n/threads 向下取整,程序没有越界,为什么仍然错误?
Q02
只启动 3 个 block,只覆盖 768 项,尾部 235 项完全没写。越界检测解决不了所有漏算;应把输出先填成哨兵,并与完整参考结果比较。
先准备 CPU 数组,再把数据交给 GPU
constexpr size_t n = 1003;
constexpr unsigned threads = 256;
std::vector<float> a(n), b(n);
std::vector<float> c(n, std::numeric_limits<float>::quiet_NaN());
for (size_t i = 0; i < n; ++i) {
    a[i] = float(int(i % 17) - 8);
    b[i] = float(int(i % 11) - 5) * 0.25f;
}
constexpr 声明编译期常量;std::vector<float> 是 C++ 的连续数组容器,这里分配在 Host。a.data() 取得首元素地址,a[i] 访问第 i 项。
% 取余让输入随位置变化;先转成 int 再减,才能产生预期负数。0.25f 的 f 表示 float 常量。
输出先填 NaN 哨兵:若有元素漏写,下载后仍为 NaN,校验就能发现。源码的 static_assert 在编译时限制规模;n==0 则在 main 中直接返回。
CUDA_CHECK:把每次调用的错误检查写全
CUDA_CHECK 是课程定义的宏。下面是 common.cuh 中的实际实现(仅调整换行):
inline void cuda_check(cudaError_t err, const char* expr,
                       const char* file, int line) {
    if (err != cudaSuccess) {
        std::fprintf(stderr, "%s:%d: %s: %s\n",
                     file, line, expr, cudaGetErrorString(err));
        std::exit(EXIT_FAILURE);
    }
}
#define CUDA_CHECK(expr) cuda_check((expr), #expr, __FILE__, __LINE__)
分配、复制、同步等 Runtime API 返回 cudaError_t 错误码;cudaSuccess 表示成功。失败时 cudaGetErrorString 转成说明文字,fprintf(stderr, ...) 输出错误,exit 终止程序。
#expr 把调用写法变成字符串;__FILE__、__LINE__ 记录调用处的文件和行号。实际 API 只执行一次。例如 CUDA_CHECK(cudaDeviceSynchronize()) 就是“调用同步,再检查它的返回码”。
cudaMalloc:申请的是字节,写回的是地址
const size_t bytes = n * sizeof(float);
float *d_a = nullptr, *d_b = nullptr, *d_c = nullptr;
CUDA_CHECK(cudaMalloc((void**)&d_a, bytes));
CUDA_CHECK(cudaMalloc((void**)&d_b, bytes));
CUDA_CHECK(cudaMalloc((void**)&d_c, bytes));
| 写法 | 含义 |
|---|---|
sizeof(float) | 一个 float 的字节数,本实验为 4;1003 项需要 4012 字节 |
float* d_a = nullptr | 声明保存地址的指针;此时还没有申请 GPU 数组 |
&d_a | 指针变量自身的地址,让 API 能把分配结果写回 d_a |
(void**)&d_a | 与 API 的通用输出指针类型 void** 对接;不做数据复制 |
地址写入 d_a,错误码交给 CUDA_CHECK。 申请成功不等于完成初始化;下一步再把 CPU 数组的值复制进去。
cudaMemcpy:先目的地,再来源,最后是方向
CUDA_CHECK(cudaMemcpy(d_a, a.data(), bytes, cudaMemcpyHostToDevice));
CUDA_CHECK(cudaMemcpy(d_b, b.data(), bytes, cudaMemcpyHostToDevice));
CUDA_CHECK(cudaMemcpy(d_c, c.data(), bytes, cudaMemcpyHostToDevice));
// 启动 kernel、检查错误并等待完成后:
CUDA_CHECK(cudaMemcpy(c.data(), d_c, bytes, cudaMemcpyDeviceToHost));
// 校验后,释放三个 GPU 数组:
CUDA_CHECK(cudaFree(d_a));
CUDA_CHECK(cudaFree(d_b));
CUDA_CHECK(cudaFree(d_c));
参数顺序为 cudaMemcpy(目的地址, 来源地址, 字节数, 方向)。H2D 是 Host → Device;D2H 是 Device → Host。
前两行上传输入,第三行把 NaN 哨兵上传到输出数组;下载会把 GPU 计算结果写回 CPU 的 c。这些变量名与短版源码一致。
cudaFree 释放 cudaMalloc 申请的内存;释放后不能继续访问。CPU 的 std::vector 会在离开作用域时自动回收自身的内存。
CPU 提交了 kernel,不代表 GPU 已经算完
add<<<blocks, threads>>>(d_a, d_b, d_c, n);
// CPU 可能已经执行到这里,GPU 仍在计算。
CUDA_CHECK(cudaGetLastError());
CUDA_CHECK(cudaDeviceSynchronize());
// 等待成功返回后,这次设备计算才已完成。
发射是提交工作;同步是等待完成。 仅用 CPU 时钟包住 <<<...>>> 那一行,通常不能得到 kernel 的完整执行时间。
本讲先用顺序清楚的程序:上传 → 启动 → 等待 → 下载 → 校验。读回结果和释放数组都放在计算完成之后。
计时部分再用 CUDA event 记录 GPU 上的执行区间。
错误检查:既检查提交,也检查完成
add<<<blocks, threads>>>(d_a, d_b, d_c, n);
CUDA_CHECK(cudaGetLastError());       // 检查 launch 等错误
CUDA_CHECK(cudaDeviceSynchronize());  // 等执行完成,检查执行错误
<<<...>>> 启动本身没有可交给 CUDA_CHECK 的返回码。cudaGetLastError() 读取并清除当前线程的 CUDA 错误状态;cudaDeviceSynchronize() 等待设备工作完成,并可能报告执行错误。
提交检查成功,不代表设备执行成功。例如越界访问发生在 GPU 稍后执行时,可能到同步或复制才被报告。
报错被发现的位置,不一定是错误发生的位置。 调试时紧接 kernel 等待,可缩小排查范围;修复后重新编译并启动程序。
运行向量加法,确认每个元素都算对
nvcc -std=c++17 -arch=sm_120 05_vector_add_demo.cu -o demo.exe
.\demo.exe
默认 N=1003 的输出应包含:
N=1003, blocks=4, threads/block=256, logical threads=1024
c[0]=-9.25, c[1002]=7, checked=1003, mismatches=0
PASS: every element matches.
checked=1003 表示 CPU 逐项比较了全部输出;mismatches=0 表示没有发现非有限值或不一致值,不是只检查打印出来的首尾两项。
将 n 改成 257,保存、重新编译再运行:应为 2 个 block、512 个线程,检查 257 项;改为 0 时直接返回空结果,不启动 kernel。演示后恢复 1003 并重新编译。
短版用 !std::isfinite(c[i]) || c[i] != expected 拒绝 NaN / Inf 与错误结果。本例输入可精确表示,逐项严格比较;尾部漏写会留下 NaN 哨兵。
再用工具检查一次设备内存访问
使用刚才的短版程序,加入 -lineinfo 重新编译,再运行:
nvcc -std=c++17 -lineinfo -arch=sm_120 05_vector_add_demo.cu -o demo.exe
compute-sanitizer --tool memcheck --error-exitcode 1 .\demo.exe
-lineinfo 保留定位源码行的信息。memcheck 检查设备内存越界、未对齐等问题;--error-exitcode 1 让工具检测到错误时返回失败退出码。
PASS 来自我们写的结果校验;ERROR SUMMARY: 0 errors 来自工具,表示这次执行未发现相应内存错误。合法地址上的错算或漏算仍要靠结果比较发现。
正式性能比较另开正常运行,不使用工具检查过程中的耗时。Compute Sanitizer 文档。
查询设备与扩展索引
复习:Block 与 SM 的关系
回顾第二讲的 GPU 执行模型:普通 CUDA block 的线程在同一个 SM 上执行;同一 SM 可以容纳多个 block。
接下来查询设备参数时,用这几个已学关系解释“每块”“每个 SM”和“整个 grid”的区别。
- 一个 grid 可以远大于 GPU 的同时驻留容量。
- block 的运行顺序、与 SM 的对应关系不由
blockIdx保证。 - warp 是硬件组织线程执行的单位;block 是程序显式表达协作的单位。
正确的结果不能依赖“block 0 总先执行”或“这些 block 一定同时驻留”。
查询实际设备,把假设变成可见信息
05_device_query.cu 核心节选:查询属性,再打印字段。
#include "common.cuh"
int main() {
    cudaDeviceProp p{};
    CUDA_CHECK(cudaGetDeviceProperties(&p, 0));
    printf("%s: CC %d.%d, SMs=%d, maxThreads/block=%d\n",
           p.name, p.major, p.minor, p.multiProcessorCount,
           p.maxThreadsPerBlock);
    int blocksPerSM = 0;
    CUDA_CHECK(cudaDeviceGetAttribute(&blocksPerSM, cudaDevAttrMaxBlocksPerMultiprocessor, 0));
    printf("maxBlocks/SM=%d\n", blocksPerSM);
}
p{} 初始化结构体,&p 让 API 写入;0 是进程可见的第 0 号 GPU。
nvcc -std=c++17 -arch=sm_120 05_device_query.cu -o device_query.exe
.\device_query.exe
线程与 block 上限:先说清“每什么”
实验设备 RTX 5090 Laptop GPU 的查询结果:
| 字段 | 实验设备值 | 限制的对象 |
|---|---|---|
warpSize | 32 | 一个 warp 的线程数 |
maxThreadsPerBlock | 1024 | block 三维线程数的乘积 |
maxThreadsDim | (1024, 1024, 64) | block 各维分别的上限 |
maxGridSize | (, 65535, 65535) | grid 各维的 block 数上限 |
maxThreadsPerMultiProcessor | 1536 | 每个 SM 同时驻留的线程上限 |
maxBlocksPerMultiprocessor(设备属性查询) | 24 | 每个 SM 同时驻留的 block 上限 |
block 的三维规模 (32,32,1) 是 1024 线程;(1024,2,1) 虽然每维单独合法,乘积 2048 仍不合法。具体 kernel 还可能受寄存器、shared memory 等进一步限制。
一个 grid 可以提交 10,000 个 block,再分批调度;grid 上限不是同时驻留数量。这些值由设备查询获得,换卡后重新查询。
内建变量、启动配置、设备上限,别混在一起
| 类别 | 例子 | 由谁决定 |
|---|---|---|
| 线程的坐标 | threadIdx、blockIdx | CUDA 根据启动网格给每个线程编号 |
| 本次启动的规模 | blockDim、gridDim | 程序员在 <<<blocks, threads>>> 中指定 |
| 硬件支持的上限 | maxThreadsPerBlock、maxGridSize | 查询设备属性得到 |
Hello 中的 <<<2, 4>>> 会让 gridDim.x=2、blockDim.x=4。它们是这次启动的值,不是 GPU 固定的默认值。
设备允许每块最多 1024 个线程,不代表应该把每次启动都设成 1024。后面的实验会比较 128、256、512 三种配置。
为什么用二维线程处理矩阵
一维也能处理矩阵。 对 3×5 矩阵,i=0…14 可以转换为 row=i/5、col=i%5。二维线程则让行、列的对应关系更直接:
// a 是 rows × cols 矩阵的行主序线性数组
size_t col = size_t(blockIdx.x) * blockDim.x + threadIdx.x;
size_t row = size_t(blockIdx.y) * blockDim.y + threadIdx.y;
if (row < rows && col < cols)
    out[row * cols + col] = 2.0f * a[row * cols + col];
dim3 是 CUDA 的三维规模类型。dim3 block(32, 8) 指定 (32,8,1),共 256 个线程;未指定分量默认为 1。kernel<<<grid, block>>>(...) 分别指定 grid 各维块数与 block 各维线程数。
二维 (32,8) 与一维 256 的线程总数相同。二维不天然更快,但便于表达矩阵小块和邻域;两种方式仍用 row*cols+col 访问线性数组,每块线程总数仍受设备上限约束。
用 3×5 小矩阵把二维索引算到地址
令 block=(4,2),矩阵 H=3、W=5,则 grid=(2,2)。
int col = blockIdx.x * blockDim.x + threadIdx.x;
int row = blockIdx.y * blockDim.y + threadIdx.y;
if (row < H && col < W) out[size_t(row)*W + col] = ...;
blockIdx=(1,1) 中,threadIdx=(0,0) 负责 (row=2,col=4),地址偏移 14;threadIdx=(1,0) 的 col=5 无效;threadIdx=(0,1) 的 row=3 无效。
线程坐标、问题坐标、内存地址分三步推,不依赖 printf 输出次序猜执行顺序。
Grid-stride loop:一个线程可以处理多项
__global__ void add_stride(const float* a, const float* b,
                           float* c, size_t n) {
    size_t start = size_t(blockIdx.x) * blockDim.x + threadIdx.x;
    size_t step  = size_t(gridDim.x) * blockDim.x;
    for (size_t i = start; i < n; i += step)
        c[i] = a[i] + b[i];
}
start 是刚才的全局线程编号,step 是本次 grid 的总线程数;i += step 表示这个线程跳到自己的下一项。
例如 <<<2, 4>>>、N=19:编号 2 的线程处理 2、10、18,再加 8 得 26,因 i<n 不成立而退出。每轮相邻线程仍访问相邻元素。
每个合法下标都有唯一分解 i = q × step + start,因此不会漏算或重复写入。本讲限定数组规模,避免循环下标溢出。
动手追踪:规模变化,分工如何保持正确
为便于观察,每 block 缩小为 8 线程;只演示索引归属,轮次不代表 GPU 同时执行。N=0 时实际程序直接跳过 launch。
把 block 数从 2 改为 1:每个线程的工作量增加,但计算结果的定义没有改变。
把元素数改为 0:Host 不应启动一个零大小 grid。
计时与性能对比
评测的三条路径:CPU、kernel、含传输
将 05_vector_add.cu 的封装展开:三段分别测量,数组已提前分配。
// ① CPU 计算:输入、输出都在 CPU
for (size_t i = 0; i < n; ++i)
    c[i] = a[i] + b[i];

// ② GPU kernel:输入已提前上传,只测 GPU 执行区间
add_stride<<<blocks, threads>>>(d_a, d_b, d_c, n);
CUDA_CHECK(cudaGetLastError());

// ③ GPU 含传输:上传 → 计算 → 下载
CUDA_CHECK(cudaMemcpy(d_a, a.data(), bytes, cudaMemcpyHostToDevice));
CUDA_CHECK(cudaMemcpy(d_b, b.data(), bytes, cudaMemcpyHostToDevice));
add_stride<<<blocks, threads>>>(d_a, d_b, d_c, n);
CUDA_CHECK(cudaGetLastError());
CUDA_CHECK(cudaMemcpy(c.data(), d_c, bytes, cudaMemcpyDeviceToHost));
①、③在 CPU 侧记录实际经过的时间,包含等待 GPU 的时间;③下载完成才停止计时。②用 CUDA event 标记 GPU 执行区间。下面解释这两种测量边界。
用 CUDA event 记录 GPU 的执行时间
kernel 启动是异步的;event 在 GPU 执行到起止标记时记时,避免只测提交耗时。
cudaEvent_t start, stop;
CUDA_CHECK(cudaEventCreate(&start)); CUDA_CHECK(cudaEventCreate(&stop));
CUDA_CHECK(cudaEventRecord(start));
for (int k = 0; k < repeats; ++k)
    add_stride<<<blocks, threads>>>(d_a, d_b, d_c, n);
CUDA_CHECK(cudaGetLastError());
CUDA_CHECK(cudaEventRecord(stop));
CUDA_CHECK(cudaEventSynchronize(stop));  // 等结束事件完成
float ms = 0;
CUDA_CHECK(cudaEventElapsedTime(&ms, start, stop));
CUDA_CHECK(cudaEventDestroy(start)); CUDA_CHECK(cudaEventDestroy(stop));
Create 创建事件,Record 放置标记,Synchronize 等结束标记完成;ElapsedTime 得到两标记间的毫秒数,Destroy 释放事件。
输入已在 GPU 上并已预热,ms / repeats 是平均每次时间。分配、传输、校验在区间外;短 kernel 的区间仍可能包含 CPU 提交间隙。
两种计时方法,对应两种测量边界
CPU 计时是由 CPU 读取时钟,不是只统计 CPU 忙碌的时间。 等待 GPU 完成的时间也算在内。
| 口径 | 从哪里开始,到哪里结束 | 本讲采用的方法 |
|---|---|---|
| Kernel 时间 | GPU 执行开始标记 → 执行结束标记 | CUDA event,观察设备执行区间 |
| 含传输的端到端时间 | CPU 开始上传 → CPU 拿到下载结果 | CPU 时钟,观察调用者总耗时 |
本例最后的阻塞下载保证结果已经取回,才读取结束时刻;因此上传、提交、GPU 计算、下载及相关等待都计入。分配和校验在计时外。
这不是强制搭配。 CPU 时钟也能测 kernel,但须等 GPU 完成,会包含提交和同步开销;event 也能包住传输,却不等于完整的 CPU 侧调用耗时。
Q03 · 讨论
GPU kernel 只需 0.1 ms,输入输出传输共 1 ms;CPU 全流程为 0.6 ms,能否宣称 GPU 加速 6 倍?
Q03
只能说相同算子执行部分的这个比较为 6 倍,且 CPU 基准口径还须一致。当前 GPU 端到端至少约 1.1 ms,比 0.6 ms 慢。若上下游数据原本就在 GPU,传输可以不属于该算子的使用场景;需要明确说明。
课堂评测:改变输入规模,比较 CPU 与 GPU
使用 05_vector_add.cu,在第五讲目录编译一次,再分别运行小数组和大数组。运行时只改元素个数 N:
nvcc -O3 -std=c++17 -arch=sm_120 -Xcompiler /O2 05_vector_add.cu -o vector_add.exe
.\vector_add.exe 65536
.\vector_add.exe 16777216
以 N=65536 的一次运行为例,输出只有这几行:
N = 65536, threads/block = 256
Check: PASS
CPU:          0.006155 ms
GPU kernel:   0.006902 ms
GPU total:    0.154335 ms
Check: PASS 表示结果校验通过。三种耗时依次是 CPU 计算、GPU 只计算、GPU 含传输总时间(H2D + kernel + D2H)。
程序固定每块 256 个线程,自动预热并重复测量,输出每次调用的耗时。比较两个规模时,先看 CPU 与 GPU kernel,再看加入传输后的 GPU total。
实验结果:kernel 快,全流程仍可能慢
实验配置为 RTX 5090 Laptop GPU + Core Ultra 9 275HX,固定 256 threads/block。下表为 5 批平均调用时间的中位数,单位 ms:
| N | 逻辑工作集 | CPU | GPU kernel | H2D + kernel + D2H |
|---|---|---|---|---|
| 0.75 MiB | 0.00628 | 0.00755 | 0.16651 | |
| 12 MiB | 0.26724 | 0.00891 | 0.92080 | |
| 48 MiB | 1.45629 | 0.01620 | 3.93208 | |
| 192 MiB | 7.28682 | 0.25450 | 17.35786 |
最大规模仅比较 CPU/kernel,约为 28.6 倍;若每次输入在 CPU、结果也要回 CPU,则 CPU/全路径仅 0.42 倍。传输改变了实际收益。
若后续计算仍在 GPU 上,可以让中间结果留在 Device,最后再下载,减少 CPU 与 GPU 之间的往返;实际收益仍要测完整流程。
本次全部结果与 CPU 参考严格一致。三个时间均不含分配、输入生成和校验;实验设备为 WDDM 笔记本,未锁频,不能把单次会话当作型号的保证性能。
读懂曲线:GPU 耗时为什么先平后升
左图两轴为对数,线越低,耗时越短;右图误差线为 5 批平均调用时间的最小与最大值。
- 青线前段近乎平坦: N 从 增至 ,扩大 16 倍,kernel 仅从 7.6 增至 8.9 μs。小任务可能受启动、调度等固定开销影响,耗时不随数据量等比例增长。
- 青线后段明显抬升: N 从 增至 ,扩大 4 倍,kernel 从 16 增至 255 μs。三个数组从 48 增至 192 MiB,超过 64 MiB L2;工作量增加,缓存复用也可能减少,具体贡献需进一步验证。
- 紫线上升,橙线始终更高: CPU 耗时随规模增加;本次计入上传与下载后,GPU 全流程仍比 CPU 慢。不能只看青线判断应用是否加速。
- 右图 256 线程最快: 增加到 512 并没有更快。每块线程更多,不保证程序更快,配置效果需要实测。
本讲小结
本讲小结
- 先认清环境:GPU 型号、计算能力、驱动和 Toolkit 各有含义。
- 再写清分工:用 block/thread 坐标找到数组位置,并处理尾部。
- 把程序跑完整:分配 → 上传 → 计算 → 下载 → 校验 → 释放。
- 最后解释性能:等待计算真正完成,分别报告 kernel 与含传输的时间。
我们已经能在 RTX 5090 Laptop GPU 上编译、运行并评测一个 CUDA 程序。下一讲继续研究:多个线程如何组织访存、复用数据。